GPT-Live-1 Prompt-to-Voice dan Sembilan Suara Baru untuk Kreator
17 Oktober 2026 · 5 menit baca · Ditulis oleh Tim Freddie Kashawan
Bagikan artikel ini
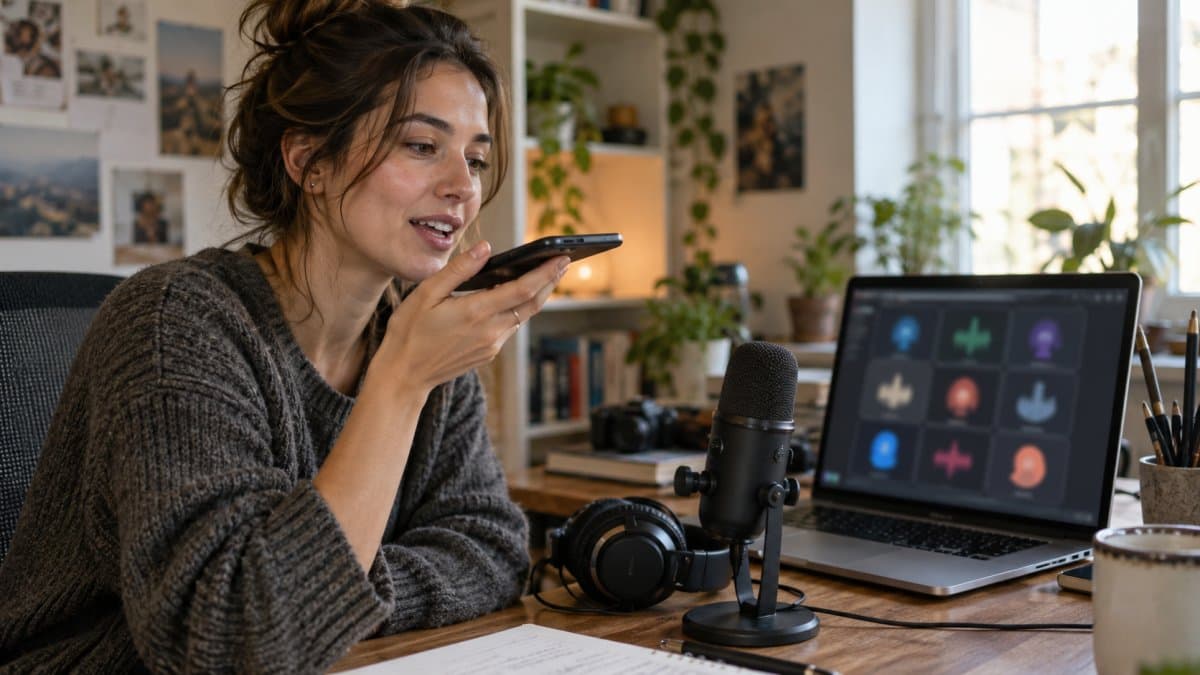
GPT-Live-1 prompt-to-voice sembilan suara internasional baru dilaporkan tersedia bagi pelanggan API menurut OrcaRouter. Fitur ini memungkinkan kreator mendeskripsikan karakter suara lewat teks, membuat sampel, lalu memakai suara tersebut kembali dalam sesi GPT-Live.
Status fitur perlu dibaca hati-hati. OpenAI, melalui halaman Introducing GPT-Live, mengonfirmasi GPT-Live sebagai model suara full-duplex. Audio yang didukung GPT-Live juga memakai watermarking SynthID sejak pembaruan yang disebutkan OpenAI. Namun, bahan primer yang tersedia tidak merinci prompt-to-voice, endpoint, daftar sembilan suara, atau ketentuan biaya yang dilaporkan OrcaRouter. Periksa dokumentasi dan dashboard API sebelum memasukkan fitur ke produk.
Apa yang dilaporkan tentang prompt-to-voice GPT-Live-1
Menurut OrcaRouter, prompt-to-voice membuat suara dari deskripsi tertulis melalui API atau Voice Playground. Suara hasilnya dapat digunakan kembali dalam sesi GPT-Live. Berbeda dari pemilihan preset, proses ini dimulai dari arahan seperti tingkat formalitas, tempo, karakter pengucapan, serta konteks penggunaan.
OrcaRouter menyebut sembilan suara baru terdiri dari Nuri, Juni, dan Flitz untuk Jerman; Brise dan Sillage untuk Prancis; Nira untuk Hindi; Harema dan Shida untuk Jepang; serta Noeul untuk Korea. Daftar ini tidak menyebut preset baru khusus bahasa Indonesia. Nama pasar tidak menjamin setiap suara cocok untuk seluruh bahasa, dialek, aksen, atau kebutuhan komunikasi.
Laporan yang sama menyatakan pembuatan suara dari prompt tidak memiliki biaya terpisah. Sintesis suara dan pengujian di Playground tetap dihitung sebagai penggunaan sesi GPT-Live. OrcaRouter juga menyebut penagihan mengikuti durasi penggunaan sesi. Ketentuan tersebut berasal dari OrcaRouter, bukan halaman primer OpenAI yang tersedia dalam bahan.
Mengapa full-duplex mengubah cara kreator mendesain audio
OpenAI menjelaskan GPT-Live memakai arsitektur full-duplex. Sistem dapat mendengar dan berbicara pada saat yang sama. Pengguna dapat menyela, memberi respons singkat, atau membetulkan pertanyaan tanpa menunggu jawaban selesai. Ini berbeda dari sistem suara bergiliran yang memproses ucapan pengguna, lalu menghasilkan balasan.
Bagi kreator, dampaknya bukan sekadar audio terdengar lebih lancar. Naskah, panjang respons, aturan interupsi, serta titik handoff ke manusia perlu dirancang untuk percakapan dua arah. Suara yang baik untuk narasi video belum tentu nyaman saat menjawab pertanyaan berulang dalam sesi langsung.
Bayangkan kreator kursus bahasa membuat latihan percakapan Jepang. Ia menyiapkan skenario formal untuk pelanggan serta dialog santai antarteman. Setiap skenario diuji dengan sapaan, koreksi pelafalan, nama orang, serta istilah asing. Penilaian berfokus pada kejelasan, kecocokan register, dan kemampuan pengguna menyela, bukan kesan unik dari satu kalimat demo.
Workflow uji suara sebelum dipakai di produk
Mulai dari tujuan komunikasi, bukan daftar suara. Tentukan pengguna, bahasa utama, situasi penggunaan, durasi percakapan, serta risiko bila respons audio keliru. Lalu buat brief suara singkat berisi tingkat formalitas, tempo, gaya penyampaian, larangan gaya, serta jenis naskah yang perlu diuji.
Tahap berikutnya, buat sampel dengan prompt-to-voice atau preset yang tersedia di akun. Uji sampel pada pembukaan, penjelasan informasi, serta respons ketika pengguna menyela. Catat masalah secara spesifik: pengucapan nama produk tidak jelas, tempo terlalu cepat pada informasi penting, atau gaya terlalu santai untuk komunikasi layanan.
Bayangkan tim pemasaran ingin menyediakan penjelasan produk berbahasa Jepang dalam format audio. Tim menulis naskah penjelasan fitur serta jawaban pertanyaan umum. Mereka membandingkan karakter suara, meminta penutur yang memahami konteks bahasa menilai pelafalan, lalu menyimpan versi yang lolos bersama prompt, naskah, catatan pengujian, serta batas pemakaian. Audio tidak langsung dipublikasikan hanya karena hasil awal terdengar natural.
Pisahkan lingkungan eksperimen dari produksi. Laporan OrcaRouter menyebut pengujian Playground masuk perhitungan sesi normal. Batas penggunaan, penamaan sampel, serta log evaluasi membantu tim membedakan suara percobaan dari suara yang telah disetujui untuk penggunaan publik.
Kontrol manusia dan provenance audio tetap diperlukan
Suara buatan AI dapat membawa risiko reputasi bila dipakai untuk pengumuman resmi, layanan pelanggan, atau materi yang menyebut harga dan kebijakan. Tetapkan materi yang boleh dibuat otomatis, materi yang harus disetujui editor, serta pihak yang bertanggung jawab saat audio mengandung kesalahan. Data pelanggan, rekaman percakapan, serta informasi internal tidak boleh dimasukkan ke prompt tanpa aturan akses yang jelas.
OpenAI menyatakan audio yang didukung dan dihasilkan melalui GPT-Live untuk ChatGPT Voice serta API mencakup watermarking SynthID. OpenAI juga menyediakan alat verifikasi publik dan akses API untuk pemeriksaan provenance pada audio yang didukung. Fitur ini dapat membantu pemeriksaan asal audio, tetapi tidak menggantikan review naskah, persetujuan publikasi, atau kebijakan penggunaan suara.
Jika produk memakai audio untuk layanan pelanggan, tentukan titik eskalasi. Sistem dapat membacakan informasi umum yang telah disetujui. Perubahan pesanan, keluhan sensitif, atau pertanyaan yang memerlukan keputusan bisnis dialihkan ke staf. Batas ini menjaga kecepatan pada tugas rutin tanpa memberi sistem suara wewenang yang tidak perlu.
Langkah yang bisa dilakukan kreator minggu ini
Buka dashboard API dan dokumentasi resmi akun. Periksa ketersediaan prompt-to-voice, daftar suara, batas penggunaan, serta ketentuan penagihan. Jangan menyamakan laporan tentang API dengan pembaruan ChatGPT Voice. Ketersediaan fitur untuk produk konsumen dan API dapat berbeda.
Pilih satu use case sempit, misalnya audio FAQ produk atau latihan percakapan. Buat satu brief suara, sampel pembanding, serta naskah pengujian untuk pembukaan, penjelasan, dan interupsi. Minta peninjauan manusia sebelum publikasi. Dokumentasikan hasilnya.
Sebelum produksi, tetapkan satu suara, satu skenario, serta satu penanggung jawab review. Hasil uji yang konsisten menjadi dasar perluasan ke bahasa, preset, atau alur percakapan lain.
Pertanyaan umum
Apa itu prompt-to-voice pada GPT-Live-1?
Menurut OrcaRouter, prompt-to-voice adalah kemampuan membuat suara dari deskripsi teks untuk digunakan kembali dalam sesi GPT-Live. Detail fitur, endpoint, dan ketersediaannya perlu diperiksa pada dokumentasi resmi serta dashboard API akun Anda.
Apa bedanya preset suara dan prompt-to-voice?
Preset suara berarti memilih karakter yang sudah disediakan. Prompt-to-voice berarti pengguna mendeskripsikan karakter yang diinginkan, lalu mengevaluasi sampel hasil sistem sebelum dipakai.
Apakah sembilan suara baru tersedia untuk bahasa Indonesia?
Daftar OrcaRouter menyebut suara untuk Jerman, Prancis, Hindi, Jepang, dan Korea. Bahan yang tersedia tidak menyebut preset baru khusus bahasa Indonesia.
Apakah membuat suara GPT-Live-1 dikenai biaya?
OrcaRouter menyebut pembuatan suara dari prompt tidak dikenai biaya tersendiri. Namun, penggunaan suara untuk sintesis dan pengujian di Playground tetap mengikuti tagihan sesi GPT-Live.
Apa yang harus diuji sebelum suara AI dipublikasikan?
Uji pelafalan, tempo, tingkat formalitas, respons terhadap interupsi, dan kecocokan pada naskah nyata. Tetapkan review manusia untuk materi publik, informasi sensitif, serta komunikasi yang dapat memengaruhi pelanggan.
Referensi
- Introducing GPT-Live · OpenAI
- GPT-Live-1 Prompt-to-Voice Sembilan Suara Internasional Baru · OrcaRouter
- #GPT-Live-1
- #prompt-to-voice
- #AI voice
Ingin menerapkan strategi ini di bisnis Anda? Lihat layanan Consulting →
Artikel Terkait
Geely Gandeng Google Bawa Gemini ke Mobil Global pada 2027
Geely gandeng Google membawa Gemini, Maps, dan Play ke mobil global mulai paruh kedua 2027, sambil menyoroti privasi dan perhatian pengemudi.
Read More →
Meta Rilis Muse Spark Open untuk Tugas AI Lokal dan Fungsinya
Meta merilis Muse Spark Open untuk dijalankan secara lokal di Mac. Simak fungsi, kebutuhan perangkat, batasan, dan cara mengevaluasi kelayakan workflow.
Read More →
Google Cabut Akses Gemini Pro dari Pelanggan AI Plus Mulai November
Google dilaporkan membatasi pilihan model Pro bagi pelanggan Google AI Plus mulai 13 November 2026. Berikut dampak, batas informasi, dan langkah evaluasinya.
Read More →